水星3:大规模扩散现象
HN ⭐ 218 · 84条评论

HN ⭐ 218 · 84条评论
MiniMax的M3.1闪存产品在人工智能指数上的评分比之前的产品高出13分,达到了42分。其价格则是前者的二分之一。在DeepSWE v1.1编码测试上,该产品的得分达到了73.7%,每个任务的成本还不到0.30美元。在性能和价格方面,它都与Deepseek V4.1闪存产品不相上下。这篇文章《MiniMax M3.1闪存产品展现了中国人工智能领域的价格竞

Kling AI发布了其视频生成工具的第4个版本。这个新版本支持长达30秒的视频片段处理,可以输入10张关键帧图像,同时其提示语处理能力已扩展到8,000个词汇量。与Wan 3.0和Seedance 2.5相比,Kling 4.0在性能上表现相当不错,但并未表现出明显的优势。这或许意味着AI视频模型的发展速度正在逐渐放缓。关于Kling AI发布带有立体音效

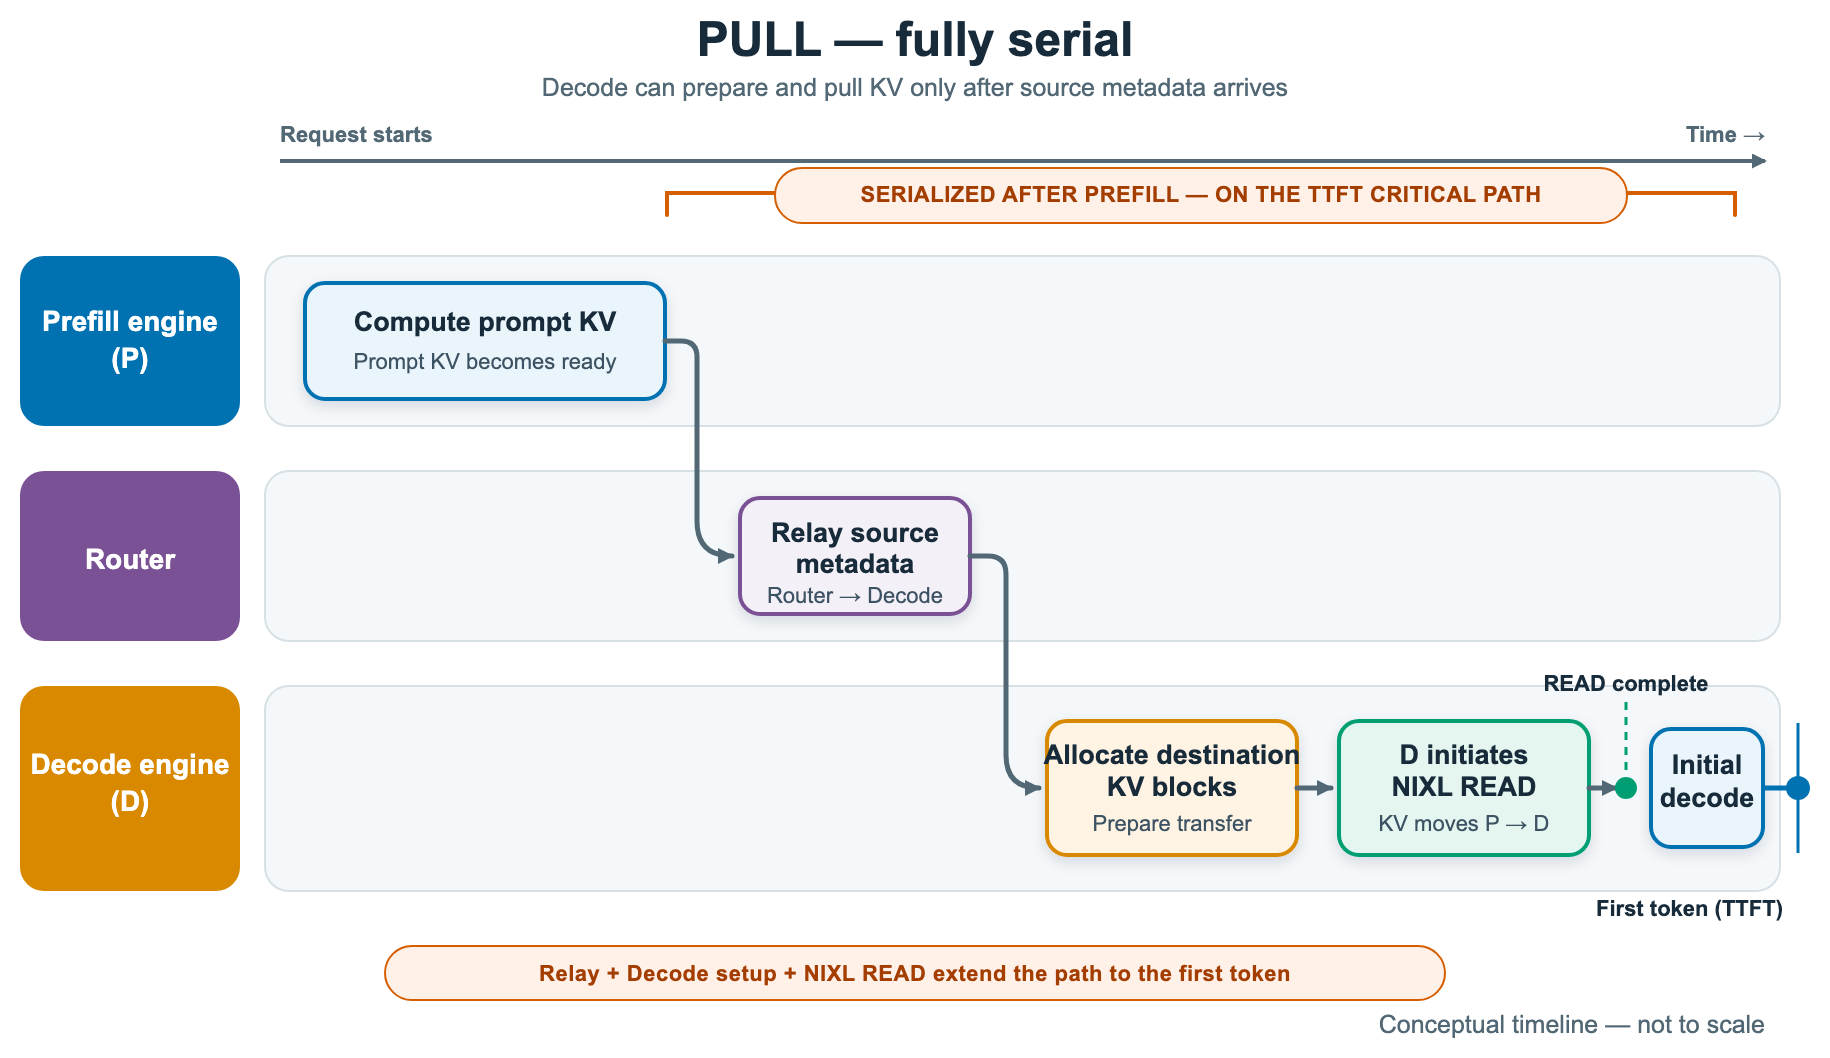
vLLM的预填充解码分离技术能够将LLM的推理任务分配到不同的引擎实例上执行,但同时还需要在这些实例之间传输键值缓存数据。这篇帖子介绍了一种基于推送方式的NIXL连接器,该连接器可以将数据传输协调工作从核心路径上分离出来,从而在使用AWS EFA的Amazon EC2 P5en实例进行的基准测试中,实现高达3倍的TTFT性能提升,以及30%的TPOT性能提升
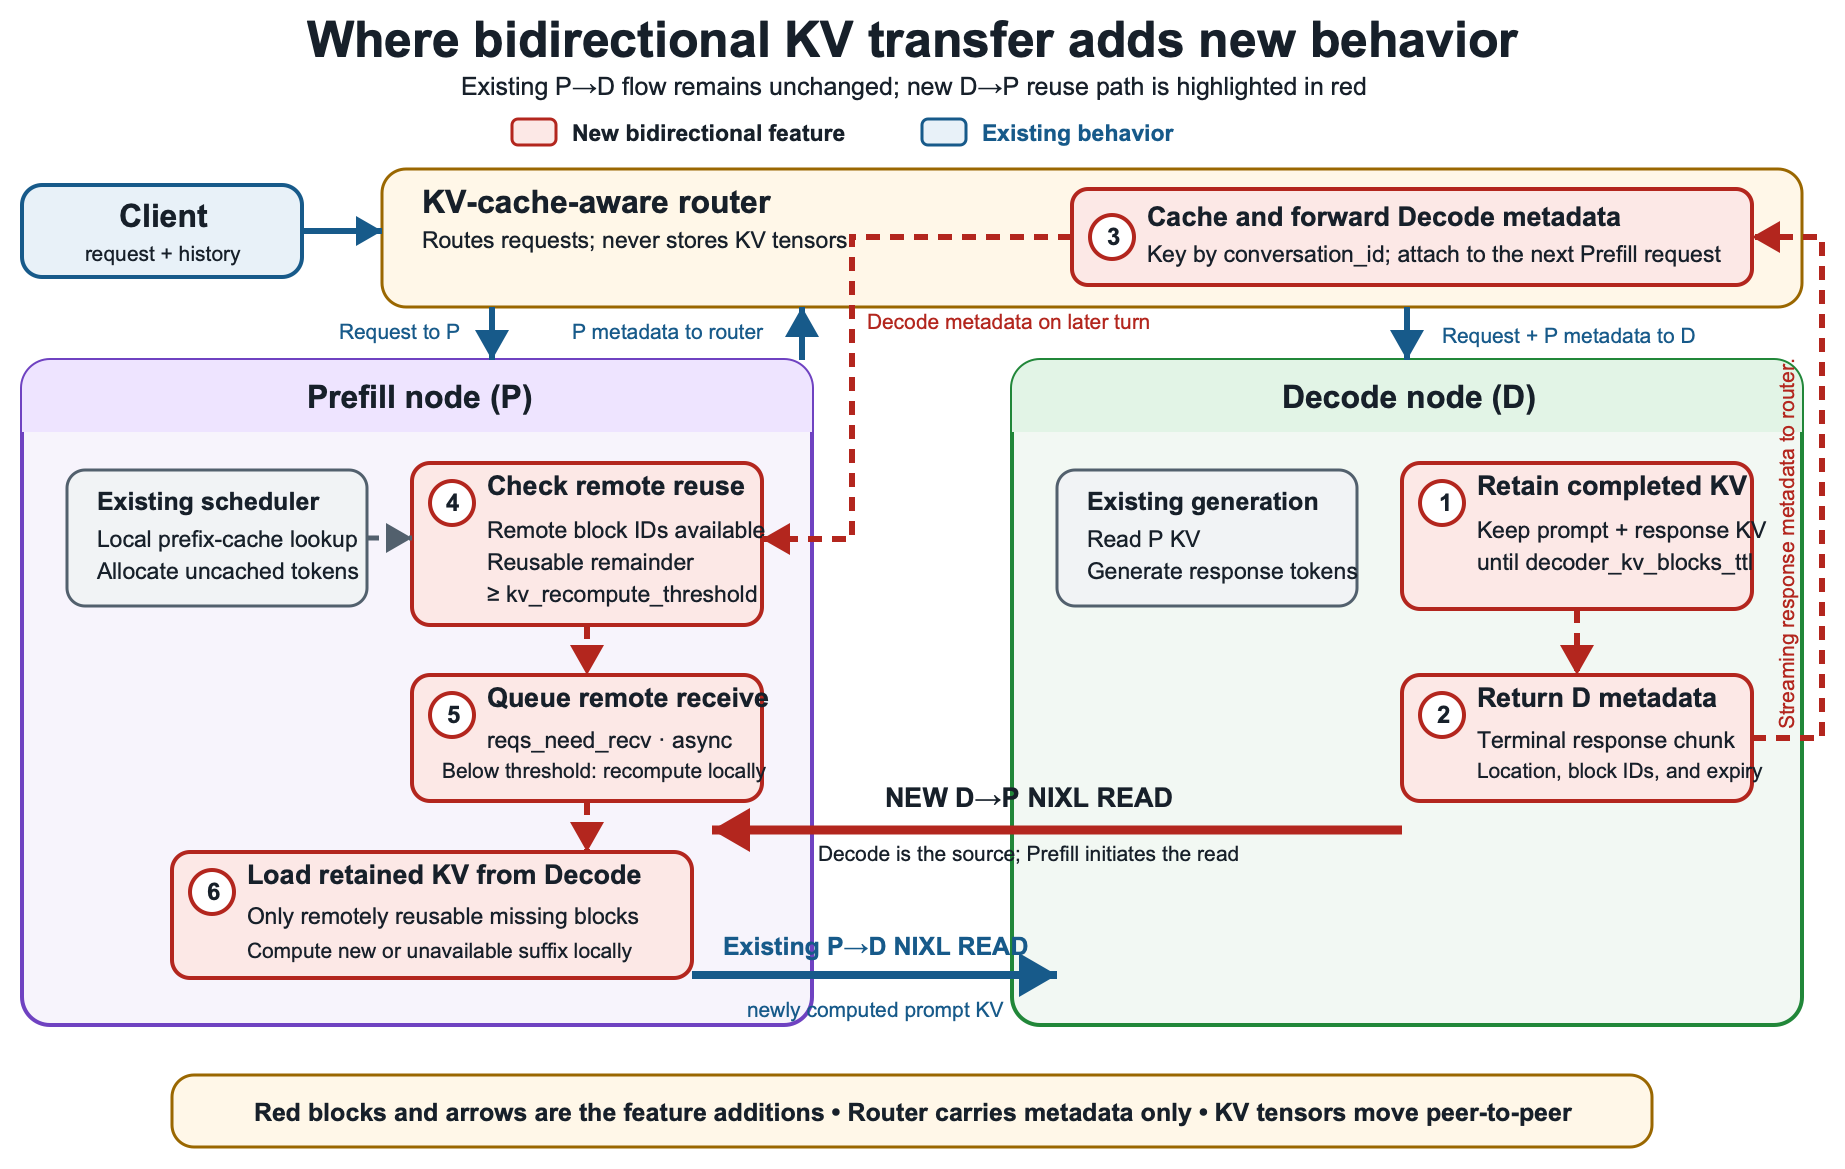
多轮代理式工作负载在每一轮处理过程中都会重新处理不断增长的对话上下文,这会导致延迟增加。而双向KV缓存传输机制则使得预填充和解码节点能够重复使用之前计算出的上下文信息,从而将首次响应时间缩短一半以上——对于Qwen3-32B模型而言,这一时间可缩短至1.6倍;而对于GLM-5-FP8模型而言,则可达3.3倍。这些效果都可以在使用EFA技术的Amazon EC
OpenCode是一款开源的人工智能编程工具,已成为Claude Code和Cursor的流行替代品。不过,黑客入侵了该平台的某些部分,盗取了一些用户的API密钥。而用户们依赖该工具寻求帮助时,这些人工智能工具却始终拒绝处理那些恶意代码。

在今年早些时候吸引了大量收购兴趣之后,这家Nvidia旗下的初创公司成功筹集了15亿美元的资金,从而继续保持独立运营状态。


HN ⭐ 7 · 2条评论
美国担心沙特政府会帮助那位前OpenAI工程师逃避间谍罪的指控。
📌 One-Sentence Summary Jediah Katz 认为,模型会吸收旧式编程辅助技巧,但智能体 Harness 仍负责开启新任务,并保障运行可靠性、权限安全与执行效率。 📝 Summary Jediah Katz 根据参与 Cursor 智能体 Harness 开发的经验,将运行时基础设施与上下文、编排层分开讨论。前沿模型已经吸收许多过去依